Snelle datafixes kosten uiteindelijk veel meer tijd
01 oktober 2026
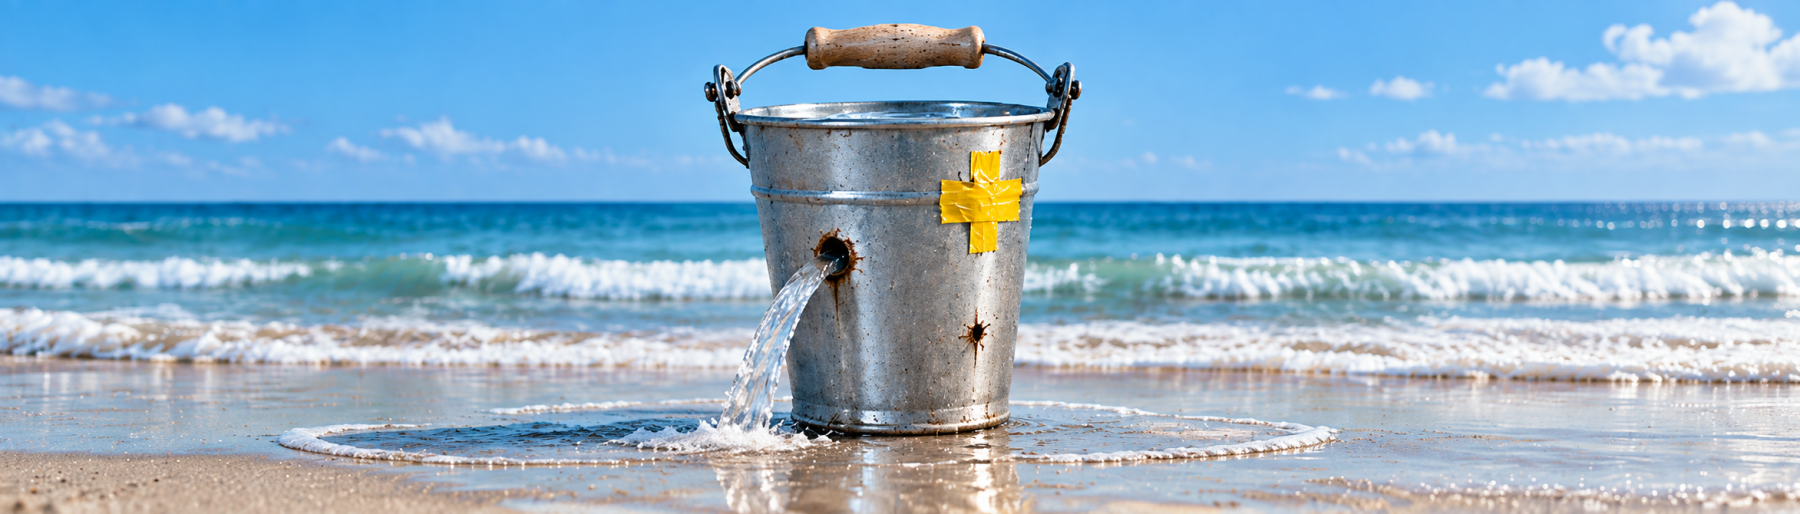
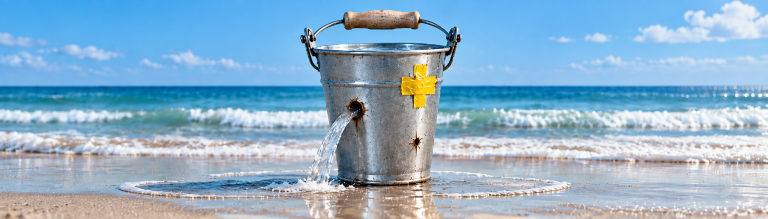
Een gat in een emmer kun je snel dichtplakken. Dat werkt, maar als het water vervolgens via een nieuw gat weer wegloopt, schiet je er weinig mee op. Dan ben je letterlijk water naar de zee aan het dragen. Met data gaat het vaak net zo. Een ontbrekende datum aanvullen of een afwijkende waarde corrigeren kost weinig tijd en houdt een rapportage voorlopig op gang. Maar als de oorzaak blijft bestaan, doen we bij de volgende rapportage hetzelfde herstelwerk opnieuw. En daarna nog eens. De snelle oplossing bespaart vandaag tijd, maar zorgt er uiteindelijk voor dat we steeds meer tijd kwijt zijn aan het herstellen van dezelfde problemen.
Wie met gegevens werkt, herkent het patroon: ontbrekende velden aanvullen, cijfers corrigeren en definities gelijktrekken. Tot de volgende rapportage hetzelfde herstelwerk vraagt. We leren niet vanzelf van een probleem dat terugkeert. Daarvoor moeten we onderzoeken waarom onze oplossing de oorzaak laat bestaan.
Wanneer versnelling tot vertraging leidt
Veel publieke organisaties hebben geïnvesteerd in een visie en strategie voor datagedreven werken. Nieuwe technologie maakt het steeds eenvoudiger om gegevens te ontsluiten en in dashboards te presenteren.Maar die versnelling heeft een keerzijde wanneer afspraken over kwaliteit, betekenis en verantwoordelijkheid achterblijven.
In een data-ecosysteem waarin mensen, processen en systemen van elkaar afhankelijk zijn, werken fouten op meerdere plekken door. Een onjuiste registratie kan terechtkomen in een managementrapportage, een prognose en een bestuurlijke verantwoording. Op al die plekken gaan mensen verschillen uitzoeken en herstellen. Wat de besluitvorming moest versnellen, gaat haar zojuist afremmen.
De kosten zitten daarmee ook in dubbel werk, uitgestelde besluiten en afnemend vertrouwen in informatie. Wie die kosten zichtbaar wil maken, kan beginnen bij één kritieke dataset: hoeveel tijd besteden medewerkers aan controleren, verklaren en corrigeren? Die tijd maakt concreet waarom verbetering aandacht verdient.
Eerst bepalen waarvoor gegevens goed genoeg moeten zijn
Niet ieder gegeven vraagt dezelfde nauwkeurigheid of actualiteit. Een dagelijks werkoverzicht stelt andere eisen dan een jaarlijkse trendanalyse. Onze eerste aanbeveling is daarom: begin bij het doel, besluit of werkproces dat je wilt ondersteunen. Bepaal welke gegevens daarvoor kritisch zijn en wat er misgaat als die niet kloppen.
Neem een dashboard over de doorlooptijd van aanvragen. Wanneer begint die termijn en wanneer is een aanvraag afgehandeld? Bij het nemen van het besluit of bij het informeren van de aanvrager? Zonder gedeelde definities kunnen twee zorgvuldig gemaakte rapportages toch verschillende uitkomsten geven.
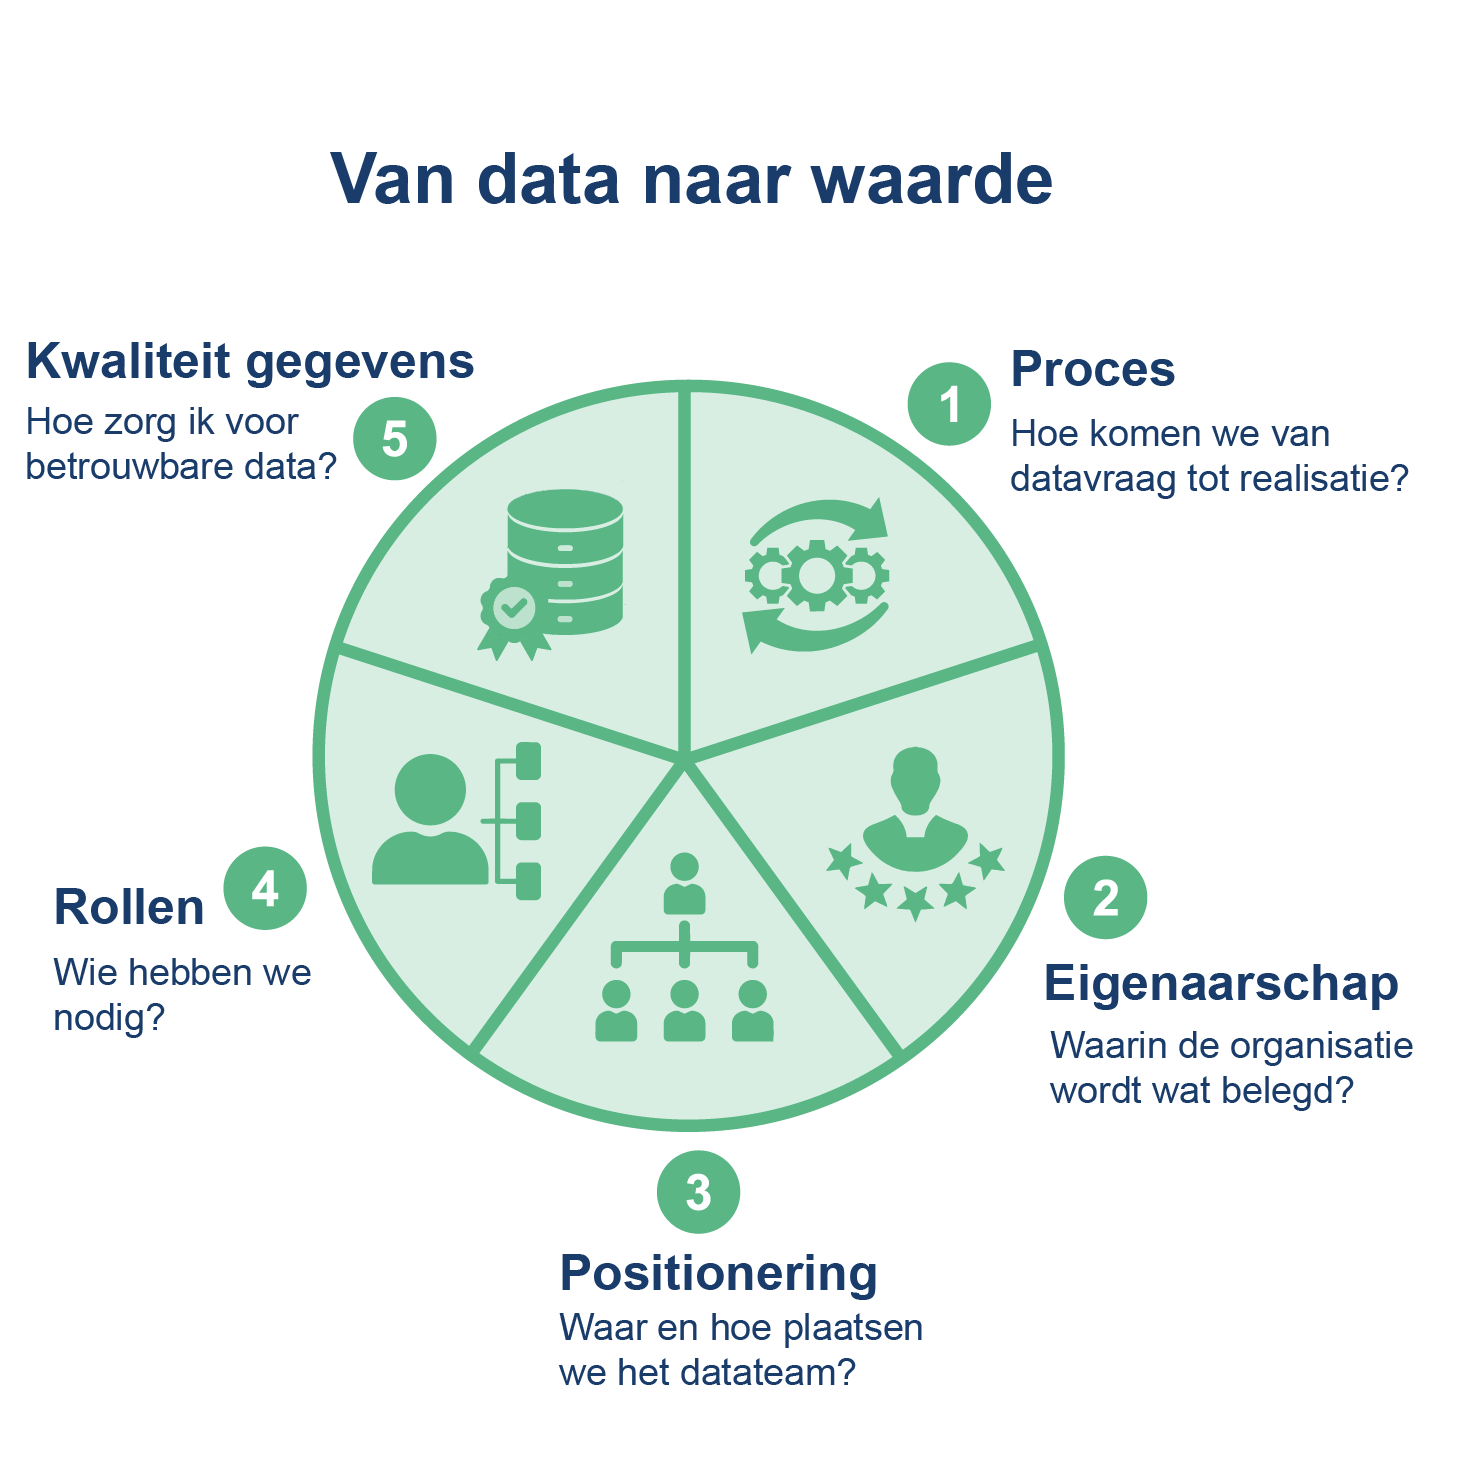
Maak daarom met gebruikers, medewerkers uit het proces en dataprofessionals concrete afspraken over betekenis en kwaliteit. Leg bijvoorbeeld vast welke einddatum wordt gebruikt, wanneer deze geregistreerd moet zijn en wie afwijkingen beoordeelt. Zo wordt ‘betrouwbare data’ een toetsbare afspraak.
De fout herstellen en de oorzaak onderzoeken
Als een datum ontbreekt, lijkt aanvullen een logische oplossing. Maar het is belangrijk te bepalen waardoor die datum ontbreekt. Is de werkinstructie onduidelijk, ondersteunt het systeem de registratie onvoldoende of weet niemand wie verantwoordelijk is? Het antwoord op al deze vragen bepaalt welke maatregel nodig is.
Wij adviseren om gegevensonderzoek te verbinden met de ervaringen van medewerkers. Technische metingen van datakwaliteit laten bijvoorbeeld zien waar en hoe vaak datums ontbreken; gesprekken over het werkproces helpen verklaren waarom. Samen bieden die inzichten een basis om de oorzaak gericht aan te pakken.
Loop daarom eens samen een gegeven na, van registratie tot rapportage. Waar ontstaat het, wie past het aan en welke bewerkingen volgen? Daarmee voorkom je dat iedere afdeling dezelfde fout afzonderlijk blijft corrigeren. Herstel waar mogelijk bij de bron en controleer ook welke afgeleide informatie moet worden bijgewerkt.
Verantwoordelijkheid moet uitvoerbaar zijn
Dit raakt aan datagovernance: samen afspreken wie waarvoor verantwoordelijk is en hoe je besluiten neemt over data. Iemand als gegevenseigenaar aanwijzen is een eerste stap. Om die rol goed te kunnen vervullen, heeft diegene ook tijd, ondersteuning en ruimte nodig om keuzes te maken over kwaliteit, prioriteiten en inzet.
Zorg daarom dat medewerkers weten bij wie ze terechtkunnen als gegevens niet kloppen. Spreek samen af wie helpt om de oorzaak te onderzoeken en wie kan besluiten over een oplossing. Betrek ook collega’s uit andere afdelingen wanneer dat nodig is, zodat een probleem niet bij één medewerker of team blijft liggen.
Directies, managers I&A, informatiemanagers en trekkers van datagedreven werken kunnen die samenwerking mogelijk maken. Door tijd vrij te maken voor verbetering en verantwoordelijkheden te verbinden aan het dagelijkse werk, helpen zij medewerkers om problemen samen op te lossen. Zo wordt het signaleren van een fout het begin van een verbetering.
Klein beginnen en het effect volgen
Je hoeft hiervoor niet eerst het hele data-ecosysteem opnieuw in te richten. Kies één informatieproduct of kritieke dataset met terugkerende problemen en breng de betrokken mensen bij elkaar. Bepaal welke gegevens aandacht vragen, meet de uitgangssituatie en kies vervolgens een haalbare verbetering.
Volg samen of de verbetering het gewenste effect heeft, bijvoorbeeld doordat gegevens vollediger zijn en rapportages minder herstelwerk vragen. Door de resultaten regelmatig in een bestaand overleg te bespreken, ontdek je wat werkt en waar bijsturing nodig is. Zo wordt leren en verbeteren onderdeel van het dagelijkse werk.
Het is niet slim om een lekkende emmer telkens weer dicht te plakken. Beter is het om te onderzoeken waarom er gaten ontstaan en wat nodig is om het probleem duurzaam op te lossen. Voor datakwaliteit geldt hetzelfde. Welke terugkerende datafout verdient bij jullie meer dan een snelle reparatie?
Een eerste beeld van jullie situatie
Wil je het gesprek hierover beginnen? Onze gratis online scan helpt je in negen vragen stil te staan bij gegevenskwaliteit, structuur en betekenis, governance, en mens en cultuur. Je krijgt op basis van je antwoorden een eerste beeld met aandachtspunten en mogelijke vervolgstappen. De scan duurt circa vijf minuten. Het is een zelfscan; de kwaliteit van de gegevens zelf wordt hiermee niet gemeten.
Nieuw aanbod gegevenskwaliteit
We hebben bij Native een nieuw aanbod rond gegevenskwaliteit met een uitgebreidere volwassenheidsmeting voor datakwaliteit en datagovernance en met concreet toepasbare tools waarmee je de daadwerkelijke kwaliteit van je gegevens kunt monitoren. Meer weten? Neem gerust contact met ons op.
Rik de Gier
r.de.gier@nativeconsulting.nl
06-21209951
J.Gotjé
j.gotje@nativeconsulting.nl
06-22933575